
Challenge: Seltene Objekte besser erkennen Studierende adaptieren KI-Modelle für unausgewogene Datenätze
Im Sommersemester 2026 fand die neunte Auflage des „Deep Learning Labs“ statt: 30 Bachelor- und Masterstudierende der TU Braunschweig fanden sich in Teams zusammen und traten in einer KI-Challenge gegeneinander an. In der Challenge sollten die Studierenden eigenständig Methoden entwickeln, mit denen ein KI-Bildverarbeitungsmodell nicht nur die häufig im Datensatz auftretenden Objekte gut erkennen kann, sondern auch seltene Objekte, die teilweise sogar nur ein einziges Mal in den Trainingsdaten auftreten.
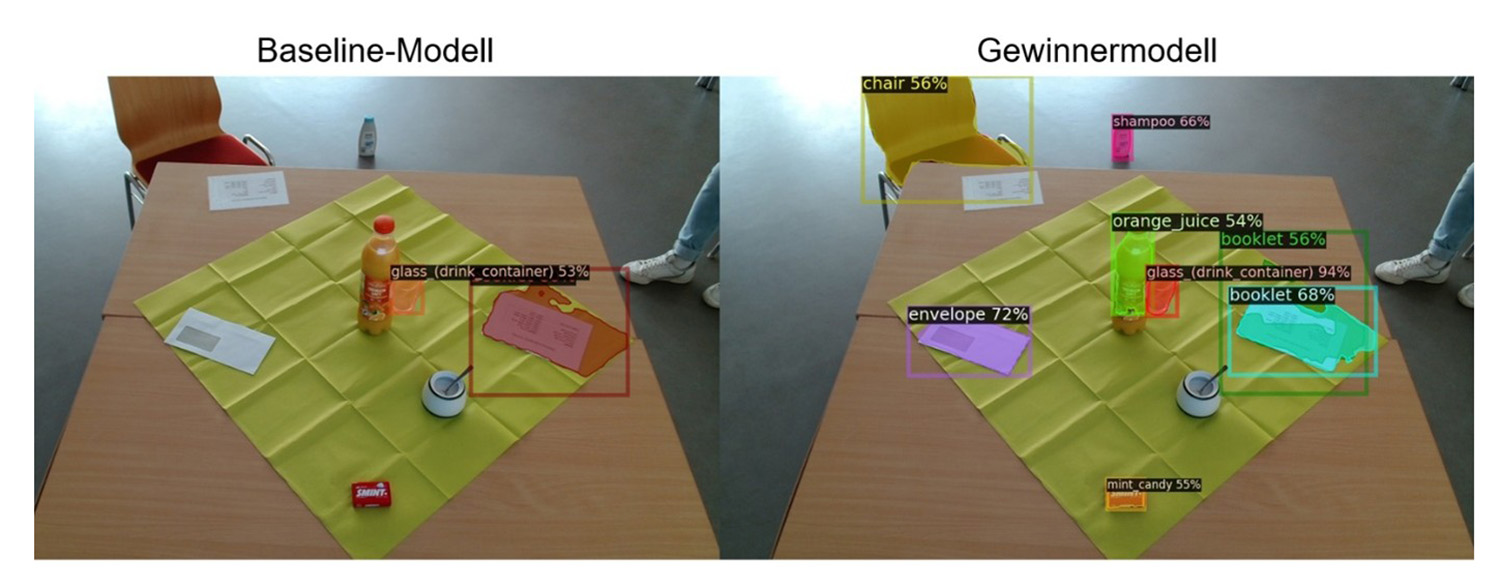
Im Live-Demonstrator erkennt das Modell des Gewinnerteams (rechts) mit hoher Sicherheit eine Vielzahl von Objekten, unabhängig davon, ob sie häufig oder selten in den Trainingsdaten auftreten. Bildnachweis: IfN/TU Braunschweig
Ob autonomes Fahren, Robotik oder medizinische Bildanalyse: Überall dort, wo KI-Systeme ihre Umgebung wahrnehmen sollen, müssen sie Objekte in Bildern finden und benennen können. Moderne Objektdetektoren beherrschen das für häufige Klassen wie Autos, Personen oder Stühle mittlerweile sehr gut. Die Realität ist jedoch nicht gleichmäßig verteilt: Während einige Objektklassen in Bilddatensätzen tausendfach vorkommen, tauchen andere nur eine einige Male auf. Trägt man die Häufigkeit aller Klassen sortiert in ein Diagramm ein, ergibt sich eine Kurve mit zunächst wenigen hohen Balken für die häufig auftretenden Klassen und im Anschluss sehr vielen flachen Balken für die seltenen Klassen, die gemeinsam den sogenannten Long Tail bilden.
Für neuronale Netze ist genau dieser Long Tail ein Problem. Sie lernen aus Daten, und wo nur wenige Daten existieren, lernen sie schlecht. Die Folge: Seltene Objekte werden übersehen oder mit häufig vorkommenden verwechselt. Oft sind aber gerade die seltenen und ungewöhnlichen Objekte wichtiger als die häufigen. Man stelle sich hierzu einen Koffer-Scanner am Flughafen vor: Dieser kann zwar Socken erkennen, aber nicht das Messer.
„In der datengetriebenen Welt stehen Häufigkeit und Wichtigkeit manchmal in einem anderen Verhältnis als in der echten Welt. In diesen Fällen muss mit gezielten Methoden ein Ausgleich geschaffen werden“, erklärt Professor Fingscheidt, Gründer und Verantwortlicher des Deep Learning Labs.
Die Challenge: Gut lernen aus wenigen Beispielen
Genau hier setzte die diesjährige Aufgabe an. Die Studierenden erhielten Bilder aus dem LVIS-Datensatz[1], in dem einige Objektklassen sehr häufig, viele andere dagegen nur selten annotiert sind. Ziel war es, ein Objektdetektionsmodell so zu trainieren, dass es auch die seltenen Klassen zuverlässig lokalisiert und benennt, ohne dadurch bei den häufigen Klassen Genauigkeit zu verlieren. Eine besondere Herausforderung in diesem Jahr war, dass die Studierenden ihre Methoden zunächst auf einem ersten Datensatz entwickeln sollten, ihre finale Lösung jedoch auf einen anderen Datensatz mit vollständig verschiedenen Objektklassen anwenden mussten, auf den sie erst zwei Wochen vor der finalen Abgabe Zugriff erhielten. Das heißt, ihre die Methoden sollten auf verschiedene Datensätze anwendbar sein.
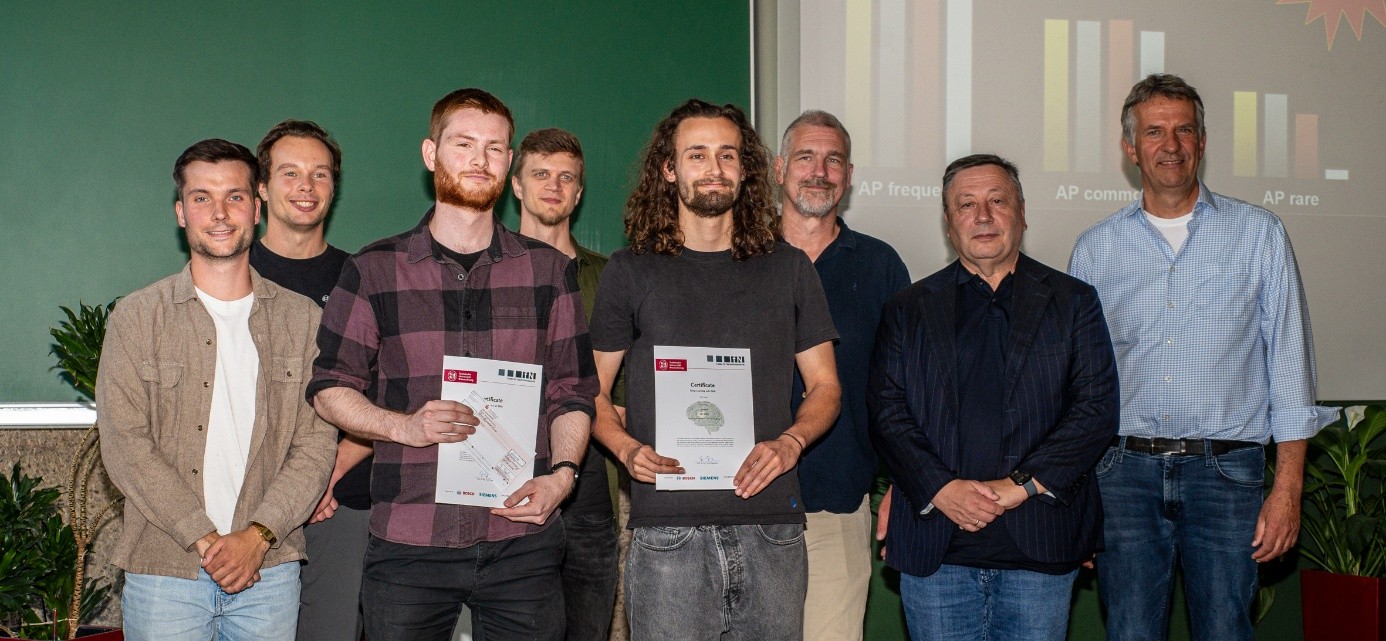
as Gewinnerteam des Deep Learning Labs 2026, bestehend aus Paul Höljes und Simon Wöhltjen. Es gratulieren die Betreuer des IfN, sowie Vertreter der Spender und Sponsoren aus der Industrie (Robert Bosch GmbH, Siemens Mobility GmbH, Volkswagen Group Innovation). Bildnachweis: Andreas Gudat/TU Braunschweig
Für diese Problemstellung gibt es keinen Königsweg, und entsprechend vielfältig waren die Ansätze der Teams. Einige gewichteten seltene Objekte im Training stärker, indem sie die Verlustfunktion des Modells anpassten oder dem Modell häufiger Beispiele seltener Objekte zeigten. Andere setzten auf die Daten-Augmentierung, also die künstliche Erzeugung zusätzlicher Trainingsdaten, zum Beispiel, indem ein seltenes Objekt aus dem einen Bild kopiert und in andere Bilder eingefügt wurde.
Die Gewinner-Teams
Das Gewinnerteam um Paul Höljes und Simon Wöhltjen ging mit dem Ansatz der Daten-Augmentierung noch einen Schritt weiter, indem die Bilder auch zur Inferenzzeit augmentiert wurden. Das KI-Modell erhält mehrere Versionen des Eingabebildes (vergrößert, verkleinert, gedreht) und bildet anschließend einen Mittelwert, was sowohl die Robustheit erhöht, als auch die Wahrscheinlichkeit, dass ein seltenes Objekt in der dargestellten Ausrichtung und Größe bereits aus den Trainingsdaten bekannt ist.
Als Würdigung erhielt das Gewinnerteam dank der Industriepartner einen Preis in Höhe von 200 Euro pro Person. Der Umweltpreis in Höhe von 150 Euro pro Person für den geringsten Verbrauch an GPU-Rechenzeit bei dennoch sehr guter Performanz ging an die beiden Studierenden Mohanad Nachar und Mudassar Iqbal.
Abschluss und Ausblick
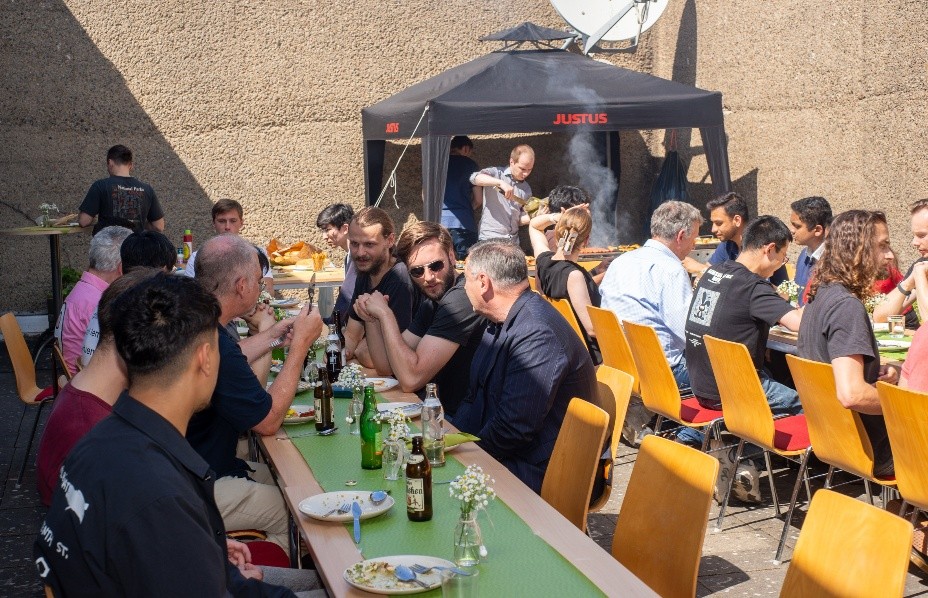
Im Anschluss an die Siegerehrung unterhalten sich Studierende, wissenschaftliche Mitarbeiter, Professoren und Vertreter aus der Industrie beim gemeinsamen Grillen auf der Dachterrasse. Bildnachweis: Andreas Gudat/TU Braunschweig
Die Abschlussveranstaltung bot den Teilnehmenden die Möglichkeit, ihre Ergebnisse vorzustellen und sich mit den Industrievertretern auszutauschen. Ein Live-Demonstrator erlaubte den Besuchern eine Auswahl an häufigen und seltenen Gegenständen vor einer Webcam zu platzieren und die eingereichten KI-Modelle in der Objekterkennung gegeneinander antreten zu lassen. Beim gemeinsamen Grillen konnten abschließend in ausgelassener Stimmung neue Kontakte geknüpft und aktuelle Fragestellungen der künstlichen Intelligenz mit großer Vielfalt diskutiert werden.